Elf dagen, een zwerm agenten, 13 miljoen regels code: een AI heeft het bewijs van de laatste stelling van Fermat machinaal controleerbaar gemaakt. Doorslaggevend was niet de rekenkracht, maar een controleur die geen enkele fout doorlaat.
Rond 1637 noteerde Pierre de Fermat een bewering in de marge van een boek, waarvoor hij naar verluidt een bewijs had. Het is nooit gevonden. Pas in 1995 publiceerde Andrew Wiles een volledig bewijs. Op 4 september 2026 meldde Anthropic dat een zwerm Claude-agenten dit bewijs volledig had geformaliseerd in de bewijstaal Lean. Dat werd mogelijk dankzij de Lean bewijsassistent, die elke stap van een bewijs machinaal controleert.
Dit artikel plaatst die melding in context. Het legt uit wat een bewijsassistent is en waarom een resultaat uit Lean als betrouwbaar geldt. Het beschrijft hoe de agenten samenwerkten en zet de melding naast olympiadeopgaven en Erdős-problemen. Daarbij worden onderbouwde cijfers, beweringen van de fabrikant en open vragen gescheiden. De stelling: nieuw is niet alleen dat een AI wiskunde bedrijft. Nieuw is de combinatie van een model dat vrij mag proberen en een programma dat elke stap onomkoopbaar afkeurt of goedkeurt.
De laatste stelling van Fermat: wat Anthropic daadwerkelijk heeft gemeld
De stelling zegt dat de vergelijking aⁿ + bⁿ = cⁿ voor gehele getallen groter dan nul en een exponent n groter dan 2 geen oplossing heeft. De uitspraak is eenvoudig te begrijpen en was eeuwenlang buitengewoon moeilijk te bewijzen. In 1908 werd een prijs van 100.000 goudmark uitgeloofd en volgens Anthropic werden alleen al in het eerste jaar 621 onjuiste bewijzen ingediend. Wiles presenteerde in 1993 een bewijs, ontdekte een hiaat en dichtte dat samen met Richard Taylor. De publicatie volgde in mei 1995.
De recente melding gaat over de vraag hoe zeker dit bewijs is wanneer elke stap door een machine wordt gecontroleerd. De belangrijkste gegevens uit de publicatie van Anthropic staan in de tabel.
| Kenmerk | Gegeven volgens Anthropic |
|---|---|
| Resultaat | Door een computer gecontroleerd bewijs van de laatste stelling van Fermat in Lean |
| Duur | 11 dagen, grotendeels autonoom |
| Omvang | 13 miljoen regels Lean-code, meer dan vijf keer zo groot als Mathlib |
| Stellingen | 29.500 tussenstellingen in het uiteindelijke bewijs, in totaal 30.300 bewezen stellingen |
| Axioma's | Alleen de drie standaardaxioma's van Lean |
| Agenten | Enkele tientallen Claude-agenten parallel |
| Rekeninspanning | Ongeveer zes miljard output-tokens van een intern, niet-openbaar onderzoeksmodel |
| Menselijk aandeel | Af en toe instructies op hoog niveau van Tianyi Peng |
| Code | Volledig bewijs openbaar op GitHub |
| Controle | Een comparator-tool bevestigde de uitspraak, Kevin Buzzard controleerde het bewijs |
Een token is hierbij een kleine tekstbouwsteen die een taalmodel genereert, bijvoorbeeld een woorddeel. Kosten in geld noemt de bron niet. Alle gegevens zijn afkomstig van de fabrikant en in deze vorm niet onafhankelijk nagerekend.
Het onderscheid is belangrijk. Het gaat om een formalisering, niet om een nieuw bewijs. De stelling was sinds 1995 bewezen. De agenten bouwden volgens Anthropic voort op een vereenvoudigde versie van het bewijs van Wiles door Darmon, Diamond en Taylor en namen onderdelen over uit het formaliseringsproject van het Imperial College en het project flt-regular. Wie leest over een AI-oplossing voor de laatste stelling van Fermat, moet dus niet denken aan een nieuwe wiskundige ontdekking, maar aan een verificatie. Anthropic maakt uitdrukkelijk onderscheid met het AI-werk aan de Riemann-hypothese, waarbij naar verluidt iets nieuws werd ontdekt.
Heeft een AI de laatste stelling van Fermat opnieuw bewezen?
Wat is Lean? Een bewijsassistent die geen enkele stap overslaat
De Lean bewijsassistent is een opensource programmeertaal waarmee wiskundige bewijzen zo kunnen worden opgeschreven dat een computer ze kan controleren. De projectsite lean-lang.org beschrijft Lean als programmeertaal en bewijsassistent met een minimale, betrouwbare kern die de juistheid waarborgt. Lean is ontwikkeld door Leonardo de Moura en in 2013 als opensource uitgebracht, zoals de Simons Foundation meldt. Sinds 2023 werkt de non-profitorganisatie Lean FRO aan de verdere ontwikkeling, onder meer ondersteund met 5 miljoen Amerikaanse dollar van de Simons Foundation International.
Het principe laat zich in alledaagse taal samenvatten. Een bewijs in Lean is een programma. De kern van Lean controleert stap voor stap of elke gevolgtrekking volgt uit de axioma's en uit reeds gecontroleerde stellingen. Axioma's zijn de basisaannames van de wiskunde die zonder bewijs gelden. Een stap die niet volgt, wordt afgewezen, hoe overtuigend hij ook klinkt. Waar nog een bewijs ontbreekt, staat in Lean de plaatsaanduiding "sorry". Een bewijs met zulke plaatsaanduidingen geldt als onvolledig.
Precies dat maakt Lean zo nuttig voor AI-modellen. Taalmodellen kunnen overtuigend formuleren en toch fouten maken. In de wiskunde is dat een probleem, want een fout in stap 400 kan alles wat daarna komt waardeloos maken. Met een bewijsassistent zoals Lean vervalt de vraag of het model te geloven is.
Het model mag gokken, falen en opnieuw beginnen. Alleen wat de controleur accepteert, komt in het resultaat.
Menselijke beoordeling werkt anders. Vakmensen lezen een bewijs, vinden het aannemelijk en vertrouwen op hun ervaring. Dat is waardevol, maar kost tijd en laat ruimte voor over het hoofd geziene punten. Al in 2021 valideerde een gemeenschapsproject in Lean een complex bewijs van Peter Scholze, zoals de Simons Foundation beschrijft. De controle door de bewijsassistent vervangt het wiskundig inzicht niet, maar geeft wel zekerheid over de juistheid.
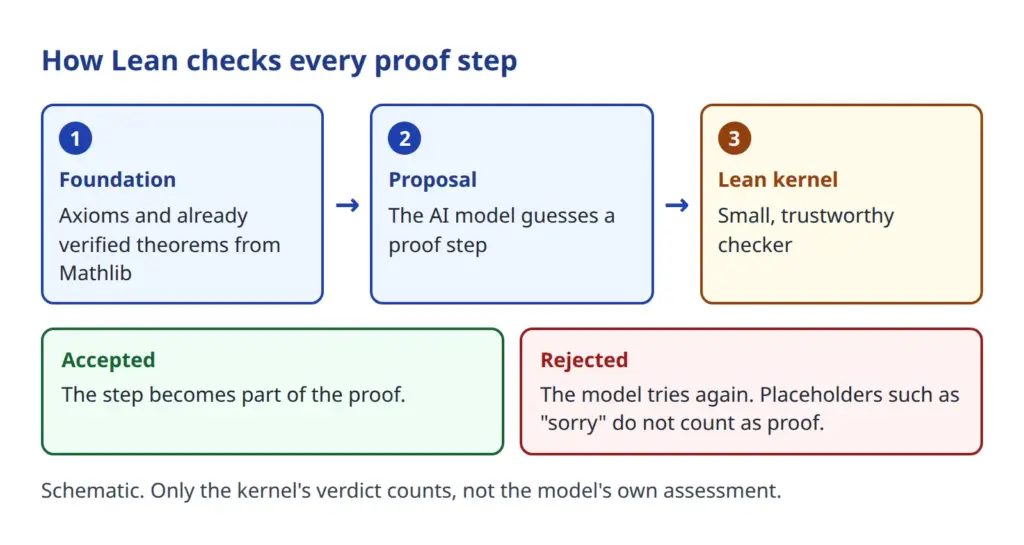
Het verloop in afbeelding 1 toont de taakverdeling: het model doet voorstellen, de Lean-kern oordeelt. Of een voorstel afkomstig is van een mens, een model of een toevalsgenerator, speelt voor het oordeel geen rol.
Mathlib en de vraag wie controleert wat er gecontroleerd is
Lean zelf bevat nog geen wiskunde. Die zit in Mathlib, de door de gemeenschap ontwikkelde bibliotheek waarop vrijwel alle formaliseringen voortbouwen. De Lean-site noemt meer dan een miljoen regels. De statistiekpagina van de community vermeldde bij het raadplegen 139.391 definities, 290.502 stellingen en 772 bijdragers. Wie in Lean iets bewijst, kan terugvallen op deze gecontroleerde bouwstenen in plaats van bij nul te beginnen.
Ter vergelijking: het Fermat-bewijs telt volgens Anthropic ongeveer 13 miljoen regels en is daarmee meer dan vijf keer zo groot als Mathlib. Dat klinkt als een gigantische nieuwbouw, maar het laat ook zien hoeveel formele verificatie van diepe stellingen kost, zelfs als Mathlib de basis levert. Het bewijs hangt af van wat al in Mathlib is geformaliseerd.
Twee controlevragen moeten afzonderlijk worden gesteld. Ten eerste: is het bewijs juist? Dat beantwoordt Lean. Anthropic geeft aan dat alleen de drie standaardaxioma's worden gebruikt. Ten tweede: is werkelijk de laatste stelling van Fermat bewezen en niet een gewijzigde uitspraak? Hier werd een comparator-tool ingezet, die bevestigde dat de geformaliseerde uitspraak overeenkomt met de formulering in Mathlib. Dit onderscheid is cruciaal. Een foutloos bewijs van een onjuiste uitspraak zou waardeloos zijn.
Het volledige bewijs staat volgens Anthropic samen met een schriftelijke toelichting op GitHub en kan daar worden ingezien. Alleen het gebruikte model is niet openbaar.
Kevin Buzzard van het Imperial College London, die het formaliseringsproject sinds 2024 leidt, controleerde het bewijs. Volgens Anthropic stelt hij vast dat de stelling wordt bewezen zonder andere aannames dan de axioma's van de wiskunde. Een beperking blijft: Lean controleert juistheid, niet betekenis. Of een resultaat interessant, elegant of belangrijk is, beoordeelt de tool niet. De Simons Foundation geeft overeenkomstige inschattingen van Alex Kontorovich weer.
Agentische AI: waarom de zwerm werkte
Enkele tientallen agenten werkten parallel. Een agent is in deze context een taalmodel dat niet alleen antwoordt, maar zelfstandig tools gebruikt, bestanden bewerkt en tussenresultaten controleert. Het multi-agentraamwerk was gebaseerd op Claude Code. De agenten definieerden begrippen, bewezen tussenstellingen en gebruikten die voor moeilijkere uitspraken. Een algemene inleiding biedt het artikel Het tijdperk van AI-agenten.
De doorbraak kwam volgens Anthropic niet van een sterker model, maar van een betere organisatie. Het platform Prove2Me, een open samenwerkingsplatform van Tianyi Peng en collega's van Columbia University, bood drie eigenschappen:
- Een gerichte acyclische graaf van de stellinguitspraken gaf oriëntatie: elke uitspraak laat zien waarvan ze afhangt, en er zijn geen kringen.
- Uitspraken en bewijzen stonden in aparte bestanden. Dat versnelt de Lean-compilatie, omdat niet bij elke wijziging alles opnieuw hoeft te worden gecontroleerd.
- Reeds bewezen stellingen konden via beschrijvingen in natuurlijke taal worden gezocht en hergebruikt.
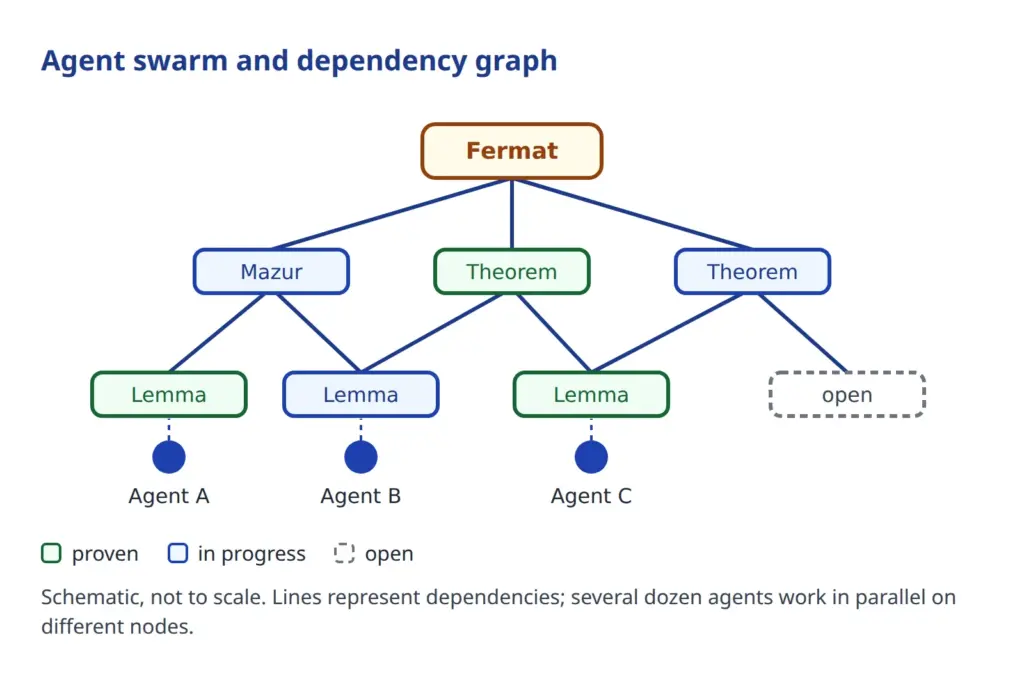
Eerdere pogingen zonder deze structuur mislukten doordat de agenten het overzicht over de stand van het project verloren. Veelzeggend is dat deze pogingen toch ongeveer 7 procent van de niet-triviale regels van het eindbewijs leverden. De les: bij grote taken wint structuur van ruwe modelsterkte. Wie veel agenten inzet, heeft een gedeeld plan, gedeelde opslag en duidelijke verantwoordelijkheden nodig. Dezelfde ervaring hebben ontwikkelaars bij elk groter agentproject.
Het menselijke aandeel bleef klein, maar was niet nul. Tianyi Peng gaf af en toe instructies op een hoger niveau, bijvoorbeeld om de Jacobi-variëteit als schema te prioriteren of de stelling van Mazur snel af te ronden. Volgens de geciteerde agentuitvoer meldde het systeem het wortelresultaat op 18 augustus om 02:00:57 UTC als bewezen.
Van de olympiade tot Erdős-problemen: AI-bewijzen sinds 2024
De Fermat-melding staat niet op zichzelf. Sinds 2024 laten meerdere resultaten zien dat AI wiskunde kan bewijzen, en ze verschillen in de vraag of Lean werd gebruikt.
In juli 2024 loste AlphaProof samen met AlphaGeometry 2 vier van de zes opgaven van de Internationale Wiskunde Olympiade op en behaalde 28 van de 42 punten, zilverniveau. De goudgrens lag op 29 punten. AlphaProof bewijst in Lean en loste onder meer de moeilijkste opgave van de wedstrijd op. De opgaven werden echter eerst met de hand naar formele taal vertaald, en de rekentijd bedroeg tot drie dagen per opgave. Deelnemers hebben tweemaal 4,5 uur.
In juli 2025 behaalde Gemini Deep Think 35 van de 42 punten, goudniveau, officieel beoordeeld door de coördinatoren van de olympiade. Het systeem werkte in natuurlijke taal binnen de tijdslimiet en zonder Lean. Dat is een bewust contrast: ook zonder formele controle wordt AI sterk, maar de resultaten zijn dan niet machinaal geverifieerd en moeten door mensen worden gelezen. Het bedrijf Harmonic beschrijft in een publicatie op arXiv zijn systeem Aristotle, dat op Lean gebaseerd bewijzoeken combineert met informeel redeneren en een meetkundeoplosser en volgens het abstract prestaties op goudniveau haalt bij de opgaven van 2025.
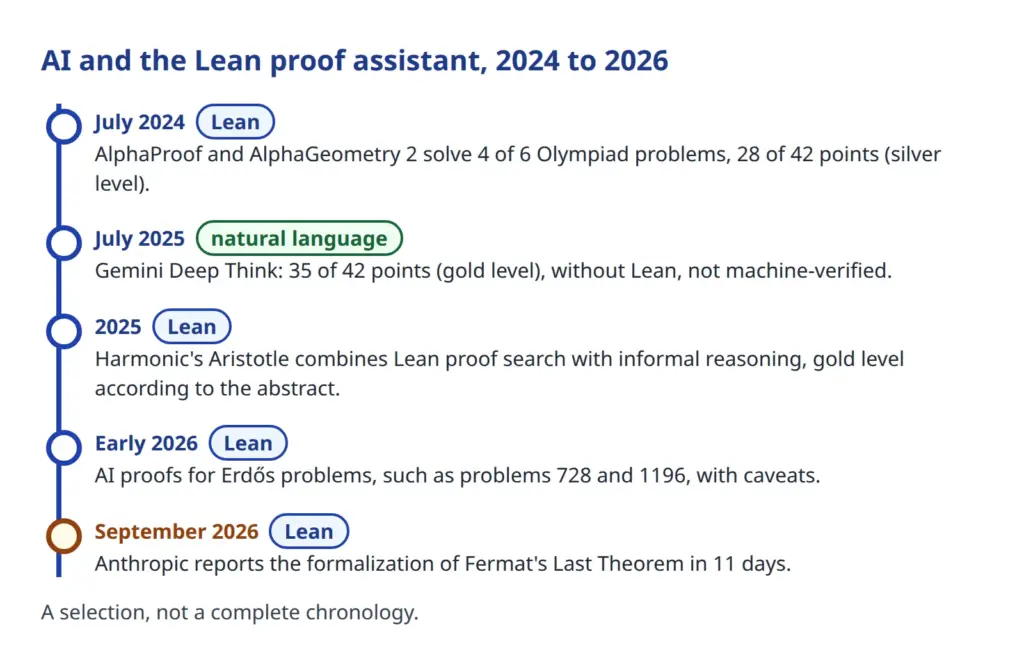
Begin 2026 kwamen de Erdős-problemen in beeld, een grote verzameling open vragen van de wiskundige Paul Erdős. Een voorbeeld is probleem 728, waarvan het bewijs door Aristotle in Lean is gedocumenteerd in een uitwerking op arXiv. Volgens de Simons Foundation loste bovendien een 23-jarige begin 2026 met ChatGPT en Lean probleem 1196 op.
De inschatting is voorzichtig. De wiki van Terence Tao over AI-bijdragen aan Erdős-problemen ziet zichzelf uitdrukkelijk niet als benchmark. Ze wijst op selectiebias, omdat successen eerder worden gedocumenteerd dan mislukkingen. Ze merkt op dat ontbrekende eerdere vooruitgang vaak wijst op onbekendheid in plaats van op moeilijkheid, dat achteraf vaak al bestaande literatuur opdook en dat een opgelost probleem niet automatisch een publicatiewaardig werk is. Tegelijk adviseert de wiki om AI-bewijzen formeel in Lean te controleren.
Het veld van AI-bewijzen in de wiskunde loopt van wedstrijdopgaven via randproblemen tot grote formaliseringen. De ontwikkeling gaat snel; of elke melding waarmaakt wat de kop belooft, moet afzonderlijk worden getoetst. Precies daarvoor is een controletool als Lean bedoeld.
Hoeveel zijn 11 dagen waard? Een tijdvergelijking zonder overdrijving
De cijfers nodigen uit tot grote vergelijkingen. Fermat formuleerde de stelling in 1637, Wiles bewees haar in 1995, dat is een tijdspanne van 358 jaar. Het formaliseringsproject aan het Imperial College werd in 2024 gestart, met een blauwdruk van 86 pagina's, en was oorspronkelijk gepland voor meerdere jaren. De AI-formalisering duurde 11 dagen.
Deze vergelijking gaat mank om meerdere redenen:
- De 11 dagen zijn de looptijd van een agentenzwerm, niet de rekentijd van een enkel model.
- Het bewijs was bekend. De AI hoefde geen nieuw idee te vinden, maar een bestaande bewijsstructuur naar Lean te vertalen.
- Er was voorwerk: Mathlib, materiaal uit het Imperial-project en uit flt-regular, en een blauwdruk.
- De inspanning van ongeveer zes miljard output-tokens van een intern model is aanzienlijk. Kosten in geld worden niet genoemd.
Het gelijkstellen van 11 dagen AI-werk met eeuwen menselijke arbeid aan het probleem is daarom slechts een retorische vergelijking. Juist is: werk dat een gemeenschapsproject over meerdere jaren had gepland, werd in enkele dagen in wezen afgerond.
Een nevenexperiment richt de blik op het dagelijks gebruik. Volgens Anthropic formaliseerden drie persoonlijke Claude Max-abonnementen in drie dagen de drie-priemgetallenstelling van Vinogradov. De auteurs achten gezamenlijke formalisering met consumentenabonnementen mogelijk als het raamwerk klopt. Dat is een inschatting van de auteurs en geen onafhankelijk onderbouwd resultaat.
Grenzen en open punten: wat de melding niet laat zien
Anthropic noemt zelf beperkingen. Het bewijs is waarschijnlijk aanzienlijk langer dan nodig, want Mathlib is compacter en beter gecontroleerd. Het hangt af van wat in Mathlib al is geformaliseerd. Het gebruikte model is een intern, niet-openbaar onderzoeksmodel, zodat het resultaat van buitenaf niet met dezelfde middelen kan worden herhaald.
Verdere punten blijven open:
- Er is geen nieuwe wiskunde voortgebracht. De formalisering vergroot de zekerheid, niet de kennis.
- Een bewijs in Lean is niet automatisch begrijpelijk. 13 miljoen regels leest niemand van begin tot eind.
- Lean zegt niets over de betekenis van een stelling, alleen over haar juistheid.
- Hoe onafhankelijk de controle is buiten de beoordeling van Buzzard om, blijkt niet uit de melding.
Lean controleert of een bewijs klopt, niet of het belangrijk is.
Voor andere afzonderlijke meldingen, bijvoorbeeld over verbeteringen bij de Riemann-hypothese of over autoformalisatie-agenten van afzonderlijke bedrijven, zijn in dit onderzoek geen primaire bronnen beschikbaar die zichzelf laten controleren. Die meldingen blijven hier daarom zonder cijfers. Ook beoordelingen van individuele experts worden alleen overgenomen als de oorspronkelijke uitspraak voorhanden is.
Wat de Lean-aanpak buiten de wiskunde betekent
Het patroon achter het Fermat-project is te generaliseren: vrij proberen aan de ene kant, strenge goedkeuring aan de andere. Het past overal waar een resultaat machinaal controleerbaar is. De Lean-site noemt als toepassingen buiten de wiskunde de verificatie van ArkLib, een bibliotheek voor SNARK's (compacte cryptografische bewijzen), en van Cedar, de autorisatietaal van AWS. In softwareontwikkeling is het principe bekend: een compiler en een testrun keuren eveneens goed of af wat een mens of een AI heeft geschreven.
Voor de omgang met AI-uitvoer levert dit een vuistregel op. Hoe beter een resultaat automatisch te controleren is, des te veiliger kan een model vrij werken. Bij teksten, inschattingen en aanbevelingen ontbreekt deze strenge goedkeuring meestal. Daar blijft de mens de controleur.
Dezelfde logica geldt voor beveiliging en gegevensbescherming: aantoonbare eigenschappen tellen zwaarder dan louter beweringen. Of een website trackers laadt of beveiligingsheaders instelt, laat zich bijvoorbeeld geautomatiseerd meten. Daarvoor biedt de websitecheck van Dr. DSGVO een mogelijkheid, en technische beveiligingseigenschappen kunnen worden getest met de security-checks. Beide zijn geen formele bewijzen in de zin van Lean, maar volgen dezelfde gedachte: meten in plaats van geloven.
Experimenten van Dr. DSGVO
Met behulp van AI is (waarschijnlijk) het wiskundige bewijs geleverd en geformaliseerd dat magische hexagonen volgens een bepaalde constructieregel bestaan voor elke n (n = randlengte van een zeshoek uit honingraatcellen).
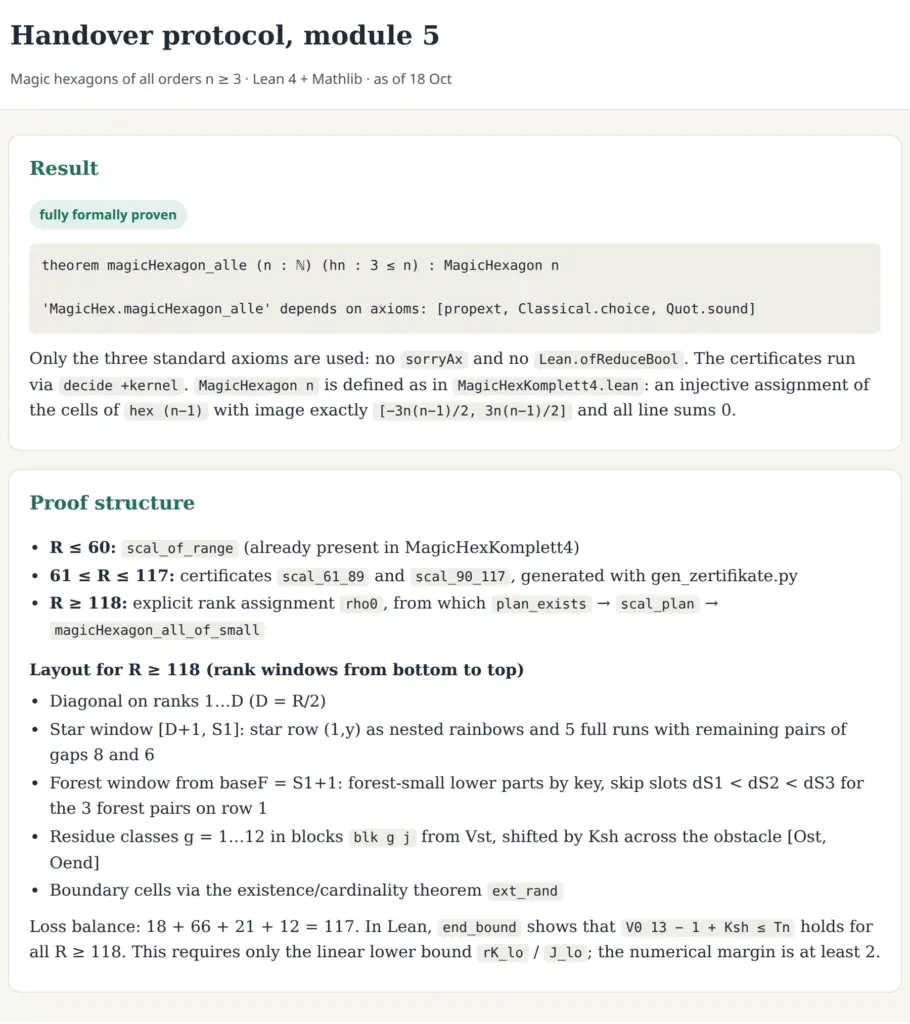
De totale AI-rekentijd bedroeg krap 9 uur. Daarvan werkte het systeem vrijwel 99,9% van de tijd autonoom en had het geen invoer nodig. De omvang van de bewijsbestanden bedroeg 173 MB! De formalisering met Lean, inclusief bibliotheken, verbruikte in tussenstappen krap 8 GB aan schijfruimte! Het hele bewijs besloeg een periode van 5 dagen. Het werd onderbroken vanwege gebruikslimieten en dergelijke.
Binnenkort wordt het bewijs hier gepubliceerd. Of het klopt, moeten bekwame mensen beoordelen die meer van wiskunde begrijpen dan de auteur, die AI gebruikte 😉
Conclusie: de revolutie is controleerbaarheid
De AI heeft de laatste stelling van Fermat niet opnieuw bewezen, maar het bewijs van Wiles volledig in Lean geformaliseerd, volgens Anthropic in 11 dagen met enkele tientallen parallelle agenten. Het succes berust op twee dingen: een organisatie die de stand van het project zichtbaar houdt, en de Lean bewijsassistent, die alleen accepteert wat volgt.
De ontwikkeling sinds 2024 laat zien dat AI steeds vaker wiskundige bewijzen levert. Hoeveel daarvan nieuw is en hoeveel bekend materiaal, moet telkens afzonderlijk worden beoordeeld, ook de Tao-wiki dringt daarop aan. Waar Lean in het spel is, blijft de juistheid controleerbaar. Dat is de eigenlijke vooruitgang: niet meer beweringen, maar machinaal gecontroleerde zekerheid.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.