Google a présenté Gemini 4 Carbon, un modèle qui, selon ses propres indications, devance nettement son prédécesseur pour trouver et exploiter des failles de sécurité. Les services de renseignement américains le reçoivent en premier, puis des défenseurs sélectionnés ; pour tous les autres, aucune date n'est fixée. Cet article fait le point sur ce qui est établi, ce qui reste une affirmation du fabricant et ce que les entreprises et les éditeurs en Europe peuvent changer dans leurs cycles de correctifs et leurs processus de contrôle.
Le 28 octobre 2026, Google a présenté Gemini 4 Carbon, quatre semaines seulement après Gemini 4 Argon. Les performances indiquées dans l'annonce sont des affirmations du fabricant et ne peuvent pas être vérifiées de l'extérieur. Plus intéressant est l'ordre dans lequel le modèle doit être distribué : d'abord des organismes publics, ensuite des défenseurs sélectionnés, sans date pour tout le monde. La veille de l'annonce de Google, le 27 octobre 2026, Anthropic a en outre publié un rapport selon lequel un modèle de recherche non publié aurait construit cinq chaînes d'exploits. Selon Anthropic et The Hacker News, les cinq ont depuis été corrigées, mais il manque une entrée publique pour le cas Android et l'attribution du cas Windows reste floue.
Sont présentés d'abord les résultats de benchmark et leurs limites, puis les étapes de l'accès et la question de ce que cette asymétrie signifie pour les organisations situées hors des États-Unis. Suivent les chaînes d'Anthropic avec leur état de correction, les conséquences pour les cycles de correctifs et les éditeurs de logiciels, ainsi qu'une liste de mesures pratiques, dont la vérification d'un serveur Linux. La situation peut évoluer rapidement.
Gemini 4 Carbon : ce qu'annonce Google et ce qui peut être vérifié
Les informations sur Gemini 4 Carbon proviennent de Google et de la couverture médiatique qui s'y rapporte.
Selon Google, Carbon atteint un peu moins de 55 % au benchmark Exploitgym ; Argon obtenait 42 % et se situait ainsi juste derrière le modèle concurrent GPT-6 Astra. Au benchmark SEC-bench Pro, Carbon dépasse légèrement 88 % et devance ainsi ce concurrent selon l'annonce. Pour CWE-bench, un test portant sur la sécurisation des failles, le chiffre avancé est de 71 %. Un benchmark est un ensemble standardisé de tâches permettant de mesurer des modèles de manière comparable. La conception exacte de ces trois tests n'a pas été examinée ici. La description s'en tient donc volontairement à ce que dit l'annonce.
D'autres affirmations proviennent également de Google : jusqu'à présent, aucune tentative d'injection de prompt n'aurait réussi, c'est-à-dire de manipulation du modèle par des instructions introduites en douce. Le modèle hallucinerait en outre moins et poserait plus souvent des questions de clarification. Aucune mesure indépendante n'existe à ce sujet. En marge, les prix sont indiqués : 4 dollars US par million de tokens d'entrée et 20 dollars US par million de tokens de sortie, avec 50 % de remise au lancement. Selon les standards actuels, ce n'est pas bon marché en comparaison, mais – au regard des valeurs absolues – pas vraiment cher non plus.
Les résultats de benchmark répondent à une question étroite : dans quelle mesure un modèle résout-il des tâches préparées ? Ils ne montrent que partiellement comment il se comporte dans un logiciel ayant évolué au fil du temps, avec des cas particuliers, un héritage technique et des responsabilités floues. Une lecture sobre suffit donc pour l'analyse. Si les chiffres de Google sont exacts, l'écart avec le prédécesseur en matière d'exploitation de failles serait important. Que cela se vérifie aussi en pratique ne se verra que lorsque des tiers pourront tester le modèle.
Accès par étapes : d'abord les services de renseignement, puis Fairwind, plus tard tout le monde
La véritable nouveauté de Gemini 4 Carbon réside dans son chemin jusqu'à l'utilisateur. Google se plie apparemment à une directive de la Maison-Blanche consistant à ne rendre les nouveaux modèles d'IA accessibles dans un premier temps qu'aux services de renseignement américains et à des utilisateurs sélectionnés. Il en résulte trois étapes.
La première étape comprend les services de renseignement américains et les utilisateurs qu'ils autorisent. Rien n'établit s'ils utilisent le modèle, ni comment. Seul l'ordre prévu est établi. La deuxième étape est le programme Fairwind, par lequel des cyberdéfenseurs sélectionnés et d'autres partenaires de confiance doivent être ajoutés progressivement. La troisième étape est le grand public. Google promet une disponibilité « bientôt », mais sans donner de date. Pour Argon, deux semaines s'étaient écoulées entre la présentation et l'ouverture aux utilisateurs payants.
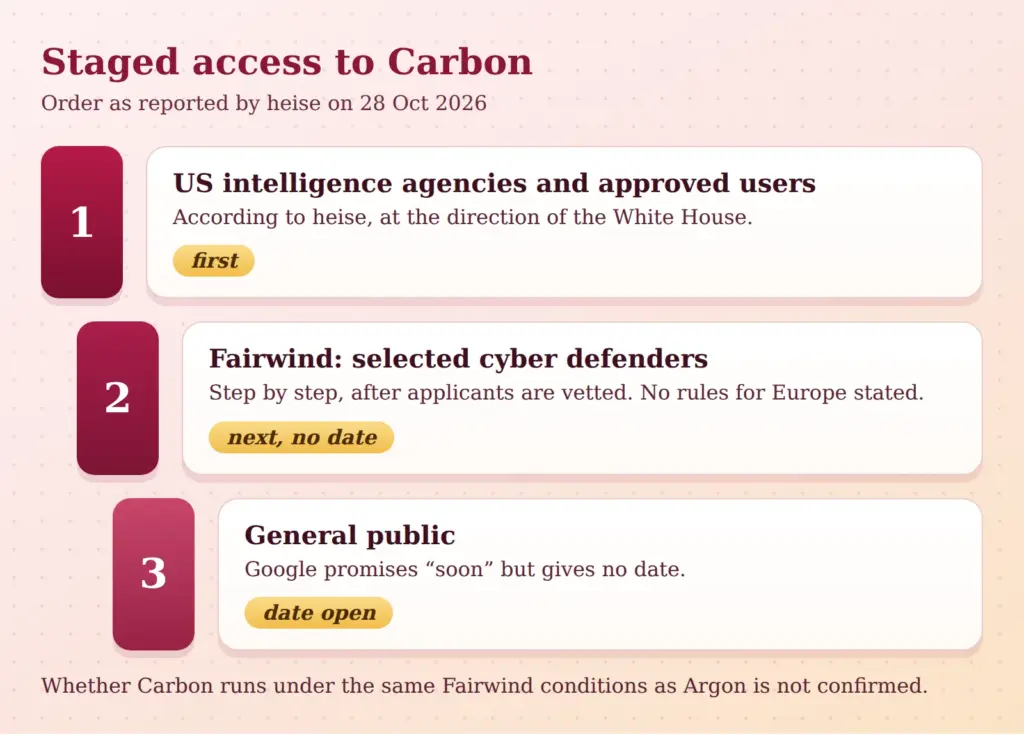
Le fonctionnement de Fairwind est décrit par Google DeepMind sur la page du programme. Plus de 650 partenaires y sont mentionnés. Peuvent participer les gouvernements et les agences nationales de cybersécurité, les exploitants d'infrastructures critiques, les grandes plateformes technologiques et les laboratoires universitaires. Les candidats font l'objet d'un contrôle. Sont exigés notamment une authentification multifacteur résistante au phishing, la journalisation et un usage défensif ; toute transmission à des tiers est interdite. La page cite toutefois Argon comme modèle, et non Carbon. On ne sait pas si Carbon est soumis aux mêmes conditions. La page ne mentionne pas de règles pour l'Europe.
Il en découle pour les entreprises européennes une asymétrie qui est d'abord une question de temps. Les États et les grandes plateformes obtiennent des outils puissants plus tôt que les PME et les éditeurs. Personne ne sait combien de temps durera cet écart. Deux questions peuvent être distinguées : qui décide de l'accès, et qu'en découle-t-il pour les organisations qui n'en font pas partie ? Apparemment, c'est la Maison-Blanche qui décide. Aux organisations situées hors des États-Unis, il ne reste qu'à attendre et à s'organiser de façon que l'avance des autres cause le moins de dommages possible.
Ce qui compte, c'est moins la qualité du modèle que la durée pendant laquelle les autres devront se passer d'un outil comparable.
L'argument contraire mérite d'être pris au sérieux. Un accès par étapes peut limiter les abus, et des défenseurs disposant d'un accès précoce trouveront peut-être les failles avant les attaquants. Reste à savoir si les attaquants obtiennent des capacités comparables ailleurs, par exemple chez d'autres fournisseurs ou avec des modèles librement disponibles. Ce n'est pas établi, ce serait une spéculation. Pour la planification, il suffit de retenir que les hypothèses d'une avance durable des défenseurs sont risquées.
Selon la page Fairwind, les organisations non éligibles peuvent utiliser l'outil CodeMender avec des modèles accessibles au public. Cela n'a pas été testé ici. Mais cela montre que des voies vers une recherche de failles assistée par IA existent aussi sans accès à l'étape supérieure.
Ce qu'Anthropic a montré : cinq chaînes d'exploits et leur état de correction
Un exploit est un morceau de code qui tire parti d'une faille de sécurité. Une chaîne d'exploits relie plusieurs failles afin qu'une petite erreur devienne une attaque complète. La Frontier Red Team d'Anthropic décrit le 27 octobre 2026 qu'un modèle de recherche interne non publié aurait construit des chaînes fonctionnelles à partir d'instructions initiales et avec peu d'intervention humaine. Le modèle n'est pas nommé et est différent de Carbon. Les deux annonces vont toutefois dans la même direction.
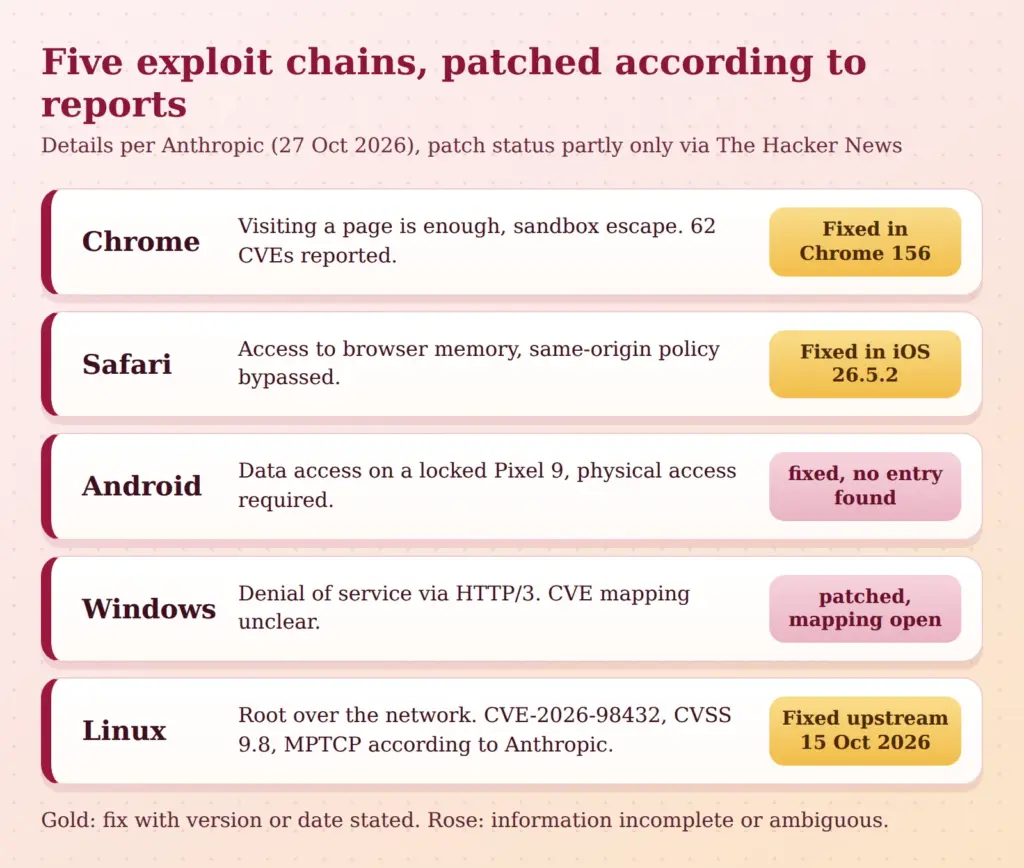
Les cinq cas en bref, chacun selon les sources citées :
- Chrome : l'ouverture d'une page suffit pour exécuter du code hors de la sandbox. La sandbox est la couche de protection qui isole les contenus web du reste du système. La chaîne combine quatre failles, dont des erreurs mémoire dans le moteur JavaScript V8, une race condition (une erreur qui dépend du déroulement temporel de processus parallèles) et un use-after-free (accès à une mémoire déjà libérée). Anthropic a signalé 62 CVE, c'est-à-dire des entrées de vulnérabilités numérotées publiquement, toutes critiques ou élevées, dont 13 évasions de sandbox selon Anthropic. Le correctif figure dans Chrome 156.
- Safari : accès en lecture et en écriture à la mémoire du navigateur, la Same-Origin-Policy est contournée. Corrigé dans iOS et iPadOS 26.5.2 selon The Hacker News.
- Android : accès aux données d'un Pixel 9 verrouillé et volé via USB. Un accès physique est nécessaire. Selon Anthropic, Google a corrigé la faille ; selon The Hacker News, aucune entrée publique n'a été trouvée.
- Windows : un déni de service via HTTP/3. Anthropic décrit une faille dans le noyau, The Hacker News renvoie à une CVE dont la description mentionne HTTP.sys. L'attribution reste floue.
- Linux : exécution de commandes en tant que root via le réseau, sans authentification, lorsqu'un listener MPTCP est actif. MPTCP (Multipath TCP) permet à une connexion d'utiliser plusieurs chemins réseau simultanément. Selon Anthropic, le contournement de KASLR, une protection du noyau reposant sur des adresses mémoire aléatoires, a pris 48 minutes, puis il a fallu cinq minutes de plus pour obtenir un shell root. La CVE citée est CVE-2026-98432 avec un score CVSS de 9,8, une valeur située tout en haut de l'échelle de gravité de 0 à 10. Selon les sources, le correctif figure dans la branche principale de Linux depuis le 15 octobre 2026.
La chaîne Linux appelle des réserves. Anthropic attribue la chaîne à une faille MPTCP et cite CVE-2026-98432. Le Debian Security Tracker décrit cependant la même CVE comme une erreur dans le code TCP IPv4, à savoir un use-after-free lors du passage d'un socket de requête au socket enfant. Le lien entre la CVE et MPTCP ne provient donc pour l'instant que de l'article d'Anthropic. Il est possible que les descriptions soient incomplètes ou que la chaîne touche plusieurs erreurs. Ce n'est pas établi.
L'analyse comporte trois limites. Premièrement, la part du travail humain n'est pas détaillée. Ce qu'un modèle a accompli seul ne peut pas être vérifié de l'extérieur, seuls les correctifs des fabricants sont visibles. Deuxièmement, un chiffre comme 62 CVE montre un volume, mais pas automatiquement une exploitation dans la nature. Les textes consultés n'en donnent aucun indice. Troisièmement, les dates de Chrome 156 (20 octobre 2026) et de la version Apple ne sont disponibles que via The Hacker News ; les sources primaires n'ont pas été consultées.
Cycle de correctifs : quand les failles sont trouvées plus vite qu'elles ne sont corrigées
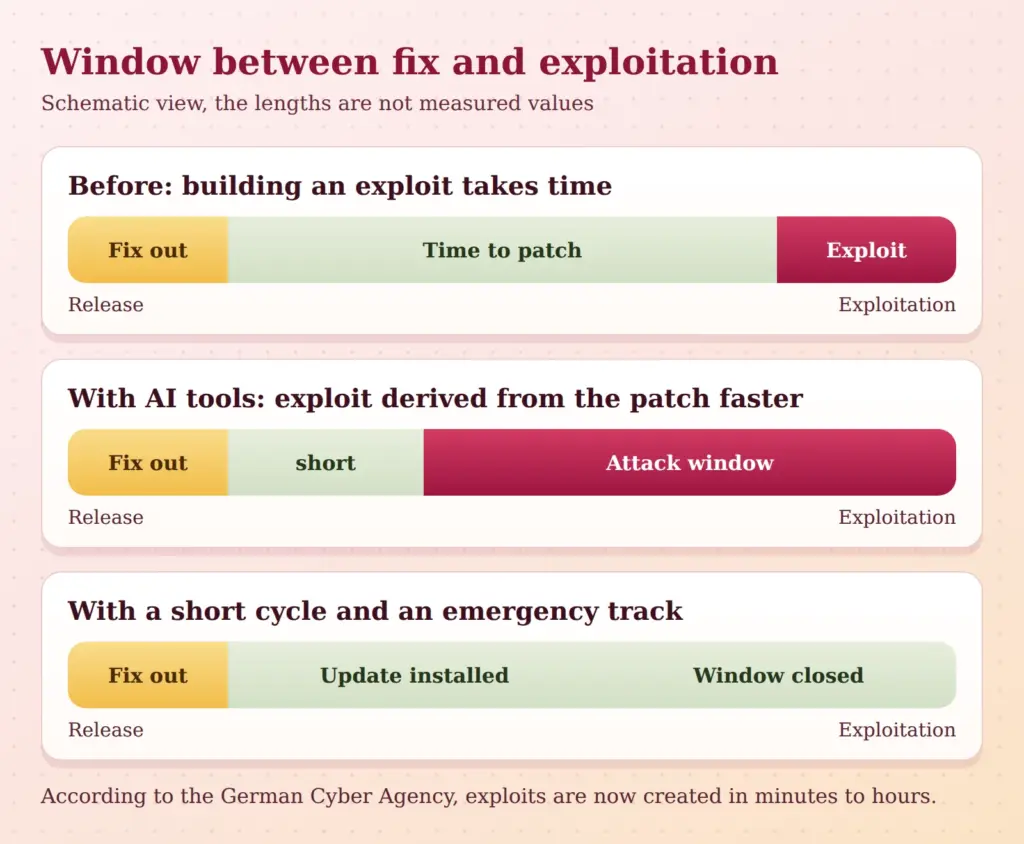
Trouver une faille n'est qu'une partie du cycle. L'application des correctifs est décentralisée : les fabricants publient des correctifs, les distributions les empaquettent, les exploitants les installent. Chaque étape prend du temps. Si des modèles trouvent davantage de failles plus rapidement et dérivent plus vite des exploits à partir des correctifs publiés, la fenêtre entre le correctif et l'exploitation se réduit. Cette dérivation à partir du correctif s'appelle le patch diffing : la comparaison de l'ancien et du nouveau code révèle où se trouvait l'erreur.
Les entreprises européennes doivent-elles corriger autrement à cause de Gemini 4 Carbon ?
L'agence fédérale allemande pour la cybersécurité estime que les attaquants ont actuellement l'avantage. Les exploits apparaissent aujourd'hui en quelques minutes à quelques heures. Pour les entreprises sans Security Operations Center propre, c'est-à-dire sans surveillance assurée 24 heures sur 24, cela signifie : classer les alertes par urgence et tenir prête une procédure d'urgence. À quoi peut ressembler un tel déroulement dans les premières minutes, c'est ce que décrit le plan d'action pour les 60 premières minutes face à un rançongiciel.
Les cas d'Anthropic entraînent deux conséquences. La première concerne le volume : une seule version du navigateur contenait des correctifs pour 62 CVE signalées. La seconde concerne le rythme : la correction Linux figurait dans la branche principale le 15 octobre 2026, les paquets des distributions ont suivi, et le moment où ils arrivent sur un serveur dépend de l'exploitant. La vitesse à laquelle des exploits apparaissent après un correctif s'est aussi manifestée récemment avec la faille PHP2Shell.
On peut en tirer les recommandations suivantes :
- Raccourcir le cycle régulier pour les systèmes d'exploitation et les navigateurs, par exemple hebdomadaire au lieu de mensuel.
- Imposer les mises à jour automatiques des navigateurs au lieu de les laisser à chaque utilisateur.
- Mettre en place une deuxième voie pour les urgences, qui se passe d'un circuit de validation des changements.
- Traiter en priorité les systèmes exposés à Internet, et mesurer les délais en jours plutôt qu'en semaines.
Une faille qu'un modèle transforme en exploit en quelques heures n'attend pas le prochain Patch Tuesday.
Éditeurs de logiciels en Europe : ce qui change dans le développement et le signalement
Les éditeurs sont à la fois destinataires et cibles de ces découvertes. Selon son propre rapport, Anthropic a pratiqué une divulgation coordonnée avec un délai de 90 jours et 45 jours supplémentaires. Cela suppose que les éditeurs puissent recevoir les signalements, les évaluer et corriger rapidement. Cela implique un contact facile à trouver pour les signalements de sécurité, par exemple via un fichier security.txt, des capacités d'analyse, des corrections y compris pour les anciennes branches stables et un rythme de publication qui permette de petits correctifs.
Sur le plan juridique, le Cyber Resilience Act est pertinent. Selon la Commission européenne, les obligations de signalement pour les vulnérabilités activement exploitées s'appliquent à partir du 11 septembre 2026, les autres obligations principales à partir du 11 décembre 2027. Les délais exacts du texte de loi n'ont pas été vérifiés ici et ne sont donc pas mentionnés.
On ne sait pas si les éditeurs européens obtiendront le même accès aux modèles de défense. Pour l'instant, il reste des alternatives : examiner les programmes d'autres fournisseurs, utiliser des outils librement disponibles et intégrer des scans de code dans son propre pipeline. Notre conclusion : partir du principe que le logiciel sera passé au crible par des modèles puissants. Qui cherche le premier trouve les erreurs avant les tiers.
Ce que les entreprises peuvent faire dès maintenant : serveurs Linux, inventaire, délais de correction
Les commandes sont des outils standard et devraient être testées dans son propre environnement avant toute utilisation en production.
Vérifier Multipath TCP
Selon la documentation du noyau, MPTCP est opt-in : les applications doivent le demander, via le type de socket IPPROTO_MPTCP. Il peut toutefois aussi être imposé de l'extérieur, par exemple avec l'outil mptcpize. Un exemple : depuis Go 1.24, les listeners créés via net.ListenConfig utilisent MPTCP par défaut sous Linux. Qu'un serveur puisse être concerné dépend donc du logiciel en cours d'exécution. Le paramètre net.mptcp.enabled s'applique par espace de noms réseau et vaut 1 par défaut.
Étapes de vérification sur un serveur :
sysctl net.mptcp.enabled
ss -Mlnp
uname -r
dpkg -l 'linux-image*'
apt policy linux-image-amd64
La première commande affiche le paramètre, la deuxième liste les sockets MPTCP en écoute avec leur processus (l'option -M n'affiche que les sockets MPTCP, les noms de processus nécessitent les droits root), la troisième la version du noyau en cours d'exécution. Les deux dernières commandes (pour Debian et les systèmes dérivés) affichent les paquets de noyau installés et leur version de paquet. Si un service Go y tourne, il peut apparaître comme listener MPTCP. Si la clé sysctl net.mptcp.enabled est absente, le noyau ne prend pas en charge MPTCP.
En raison de l'attribution incertaine de la CVE, il ne suffit pas de désactiver MPTCP. Ce qui compte, c'est le niveau du noyau, plus précisément la version du paquet du noyau installé. La vérification diffère selon la distribution : les distributions rétroportent souvent les correctifs dans des noyaux plus anciens, de sorte que la sortie de uname -r seule (par exemple 6.1.x) ne dit rien sur l'état de correction. C'est la version du paquet indiquée dans l'avis de sécurité de la distribution concernée qui fait foi. Le Debian Security Tracker indique comme corrigées sous bookworm les versions 6.1.190-1 (Security) ou 6.12.113-1~deb12u1, sous trixie 6.12.113-1 et sous forky 7.2.12-1. C'est l'état selon le tracker, qui devrait être consulté à nouveau le jour de la mise en œuvre. Pour Ubuntu, Red Hat et SUSE, les pages de sécurité n'ont pas été consultées et doivent être vérifiées par vos soins. Après la mise à jour du noyau, un redémarrage est nécessaire, sauf en cas de live patching.
Navigateurs, systèmes d'exploitation, inventaire
- Navigateurs : Chrome en version 156 ou supérieure, iOS et iPadOS en 26.5.2 ou supérieure, installer les mises à jour Windows. Imposer les politiques de mise à jour dans la gestion des appareils.
- Délais : navigateurs et systèmes d'exploitation exposés à Internet en premier, délais en jours. Les chiffres sont indicatifs.
- Inventaire : sans inventaire, personne ne sait quel noyau tourne sur quel serveur ni s'il existe un listener MPTCP. L'inventaire est la base de toute correction rapide.
L'IA côté défense : scan de code lors des pull requests
Une pull request est une proposition de modification du code source, examinée avant son intégration. Un scan de code lors des pull requests fait vérifier automatiquement chaque modification par un modèle en complément. Cela complète l'analyse statique et la revue humaine, sans les remplacer. Les résultats doivent être évalués par des humains, car les fausses alertes sont courantes et coûtent du temps.
Les réglages typiques sont un scan à chaque pull request, un blocage en cas de découverte critique et une documentation des exceptions. La protection des données et la confidentialité doivent être clarifiées au préalable : le code source est transmis à un fournisseur. Le contrat et la Zero Data Retention, c'est-à-dire l'engagement que les entrées ne sont pas stockées, devraient être vérifiés. La page Fairwind mentionne cette option pour Argon dans Gemini Enterprise. Aucune recommandation de produit n'est volontairement faite ici.
Le regard extérieur
Un contrôle de site web montre quels services et quelles technologies un site révèle vers l'extérieur. Les Security-Checks complètent cela par les défauts de configuration visibles. Ni l'un ni l'autre ne remplace les mises à jour du noyau ou la vérification du code, mais ils offrent une vue extérieure, telle qu'un attaquant l'aurait aussi.
Conclusion : gagner du temps plutôt que courir après les outils
L'accès aux modèles les plus puissants est inégalement réparti ; pour tous les autres, l'effet se manifeste par davantage de découvertes et des correctifs plus rapides. Les défenseurs gagnent du temps grâce à des cycles plus courts, un inventaire entretenu et des contrôles automatiques dans le développement.
Restent en suspens la date pour le grand public, les règles pour l'Europe et la mesure indépendante des indications de Google, qui devraient continuer d'être suivies.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.