Голова Google Сундар Пічаї каже, що галузь ще далека від кінцевого стану рекурсивного самовдосконалення, тобто самовдосконалюваного ШІ в повному сенсі. Водночас він описує цикли, у яких ШІ-агенти вже сьогодні допомагають створювати нові моделі. На сьогодні можна розібратися, що з цього підтверджено і що це означає для використання ШІ в малих і середніх підприємствах. Чи загрожує це людству?
Приводом стало інтерв’ю, про яке Big Technology повідомило 23.10.2026. У ньому прозвучала фраза про самовдосконалюваний ШІ, яку легко цитувати: галузь ще далека від кінцевого стану RSI. RSI означає Recursive Self-Improvement, тобто рекурсивне самовдосконалення. Ідеться про цикл, у якому системи ШІ вдосконалюють своїх наступників, а ті, своєю чергою, створюють ще кращих наступників.
Основи роботи таких циклів пояснює стаття про рекурсивне самовдосконалення ШІ. Висловлювання з інтерв’ю, заяви виробників про себе, наукова робота та прогноз інсайдерів далі розглядаються окремо одне від одного.
Що Пічаї сказав, а чого ні
Суть коротка. За повідомленням Алекса Кантровіца, Пічаї сказав: «To be very clear. We are pretty far from the end state of RSI.» Це означає приблизно таке: «Скажу чітко: від кінцевого стану рекурсивного самовдосконалення галузь ще досить далеко». Кантровіц протиставляє цю фразу очікуванням декого в галузі ШІ, що вибух інтелекту ось-ось настане і ШІ незабаром удосконалюватиметься в повному циклі без участі людини.
Одразу після цього звучать ще два речення, які для оцінки важливіші за перше. Пічаї сказав: «You have RSI loops along with AI researchers in various aspects of model development.» І: «You almost have agents helping AI researchers in some automated way work together to build these models.» За змістом: у різних сферах розробки моделей уже є цикли зворотного зв’язку разом із дослідниками, а агенти частково автоматизовано допомагають їм створювати моделі.
Дослівно підтверджено, отже, таке: часткові цикли вже працюють, і саме разом із дослідниками. Про модель, яка без нагляду сама себе перебудовує, у цих реченнях не йдеться. Фразу про кінцевий стан можна прочитати так, що мається на увазі саме така картина.
Як побічну тему Big Technology згадує обчислювальні потужності. Пічаї каже, що їх бракує всім, не лише Google: «The compute we have today is a function of decisions I made in 2024.» За повідомленням, він також каже, що хмарний бізнес раз у раз відмовляється від короткострокових доходів, бо обчислювальні потужності резервуються для розробки передових моделей. Для самовдосконалення це важливо, адже кожен цикл з ідеї, експерименту та оцінки коштує обчислювального часу. Там, де його бракує, він гальмує й автоматизовані дослідження.
Часові рамки не підтверджені. Вторинні джерела, як-от DigitalToday, називають «наступний рік» як час подальшого прогресу.
Далі йде тлумачення, яке не належить Пічаї. Хто говорить про кінцевий стан, той припускає, що до нього веде шлях і що цей шлях уже розпочато. Тому фразу можна прочитати й як висловлювання на користь RSI: розвиток відбувається, Google просуває його з великими зусиллями, і за кілька років можливі великі успіхи. Це очікування є власною оцінкою. Відповідного висловлювання Пічаї в опрацьованих джерелах немає.
Можливе прочитання: хто говорить про кінцевий стан, той припускає, що шлях до нього вже розпочато. Тоді ця фраза є не стільки заспокоєнням, скільки визначенням поточної позиції.
Самовдосконалюваний ШІ: цикл агентів проти зміни ваг
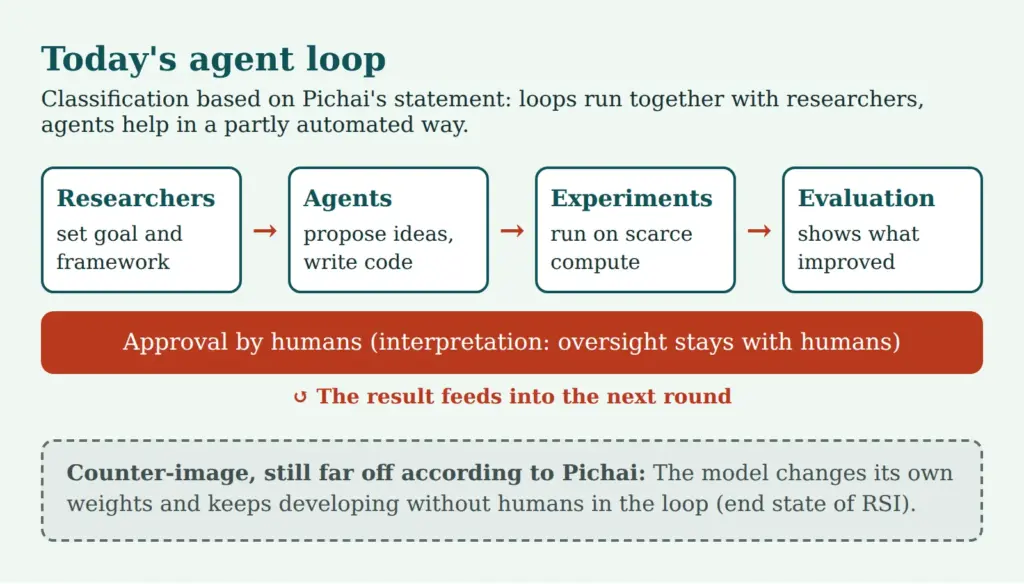
За цим поняттям стоять дві дуже різні речі, які в повсякденні часто плутають. Перша – цикл агентів. Тут ШІ-агенти беруть участь у розробці: пропонують експерименти, пишуть і змінюють код, запускають навчальні прогони, оцінюють результати та звітують. Люди ставлять цілі, перевіряють результати й ухвалюють рішення про зміни. Такий цикл удосконалює процеси, інструменти та робочі процедури.
Друга – зміна ваг. У цьому випадку модель змінювала б власні ваги так, щоб наступник був кращим, і до того ж без того, щоб людина між етапами затверджувала результати. Саме ця картина стоїть за поняттям вибуху інтелекту. І саме від цього, як можна прочитати слова Пічаї, галузь ще далека.
Між цими полюсами немає перемикача, є спектр. Кількість кроків, які агенти виконують без запиту, може зростати. Разом із нею зростає частка розробки, яку люди контролюють лише вибірково. Як агенти діють на практиці і чому це потребує контролю, описано у статті про епоху ШІ-агентів.
Центральне питання заслуговує на тверезу відповідь. Її можна вивести з підтверджених речень.
Чи Google уже займається рекурсивним самовдосконаленням, якщо ШІ допомагає створювати наступні моделі?
Для МСП ця різниця не академічна. Цикл агентів прискорює цикли моделей, і втрата контролю тут не є темою. Зміна ваг без нагляду порушила б питання, чи можуть люди ще відстежувати зміни. Обидва питання потребують різних відповідей, і на практиці сьогодні постає лише перше.
Що Google та інші повідомляють про власний прогрес
Заяви виробників про власний прогрес – це самозвіти. Вони можуть бути правдивими, але незалежно не перевірені. Це стосується всього, що наведено в цьому розділі.
Актуальний приклад – Flint. Компанія Recursive у своєму анонсі представляє модель як швидку модель для програмування на локальному обладнанні, із 40 мільярдами параметрів загалом і 2,5 мільярда активних на токен (тобто модель типу Mixture of Experts). За її власними словами, невелика команда людей та агентів створила її менш ніж за чотири місяці. Автоматизована дослідницька система «Eureka Machine» нібито брала участь у розробці майже кожної ланки ланцюга створення моделі, від даних і рецептів навчання до інференсу. Бенчмарки надав виробник, і незалежно вони не перевірені. Recursive сама попереджає, що Flint може потребувати більше вказівок, ніж великі закриті моделі.
Для компаній це цікаво з двох причин. По-перше, випадок показує, що автоматизовані дослідження вже дають продукти, і навіть у малих командах. По-друге, модель працює локально. Хто не хоче надсилати чутливі дані хмарним провайдерам, отримує ще один варіант, проте заяви виробника цим не доведено. Як оцінювати локальні моделі в компанії, показує огляд локального ШІ на підприємстві.
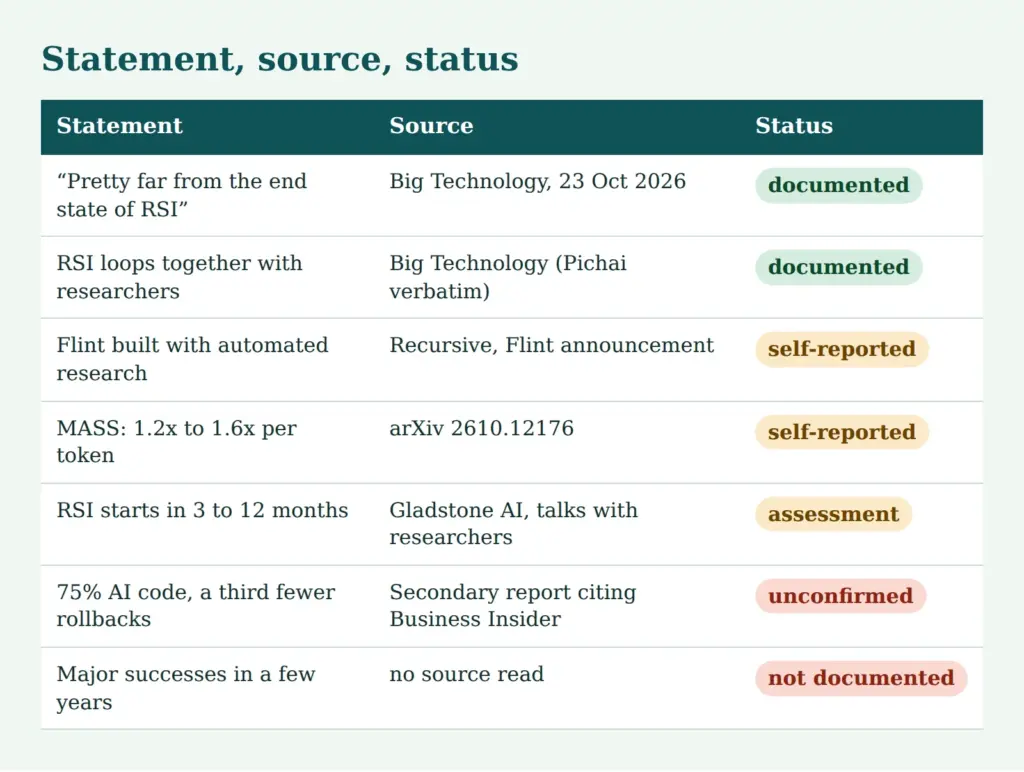
Огляд показує, як слід класифікувати висловлювання в цій статті. Підтверджено два речення Пічаї у формулюванні повідомлення. Цифри виробників і дослідників є самозвітами. Gladstone – це оцінка на основі розмов із дослідниками, а не вимірювання. Цифра щодо коду залишається непідтвердженою, а нібито часові рамки «за кілька років» не підтверджені як висловлювання Пічаї.
Що показують дослідження і де вони закінчуються
Одна наукова робота наочно показує, як може виглядати такий цикл. Під назвою «Recursive Self-Improvement through Multi-Agent Self-Supervision» (подано 8 жовтня 2026 року) описано метод MASS. Одна базова модель, у статті Qwen3.6-27B, пропонує багатоагентні робочі процеси, виконує їх і сама їх оцінює. Потім її донавчають на власних прогонах, і процедура повторюється.
Після двох циклів анотація повідомляє про продуктивність у 1,2–1,6 раза вищу на вихідний токен на чотирьох відкритих бенчмарках. Крім того, модель, навчена на прогонах кількох агентів, нібито краща за модель, навчену на прогонах одного агента з на 40 відсотків більшим обсягом навчальних даних.
Обмеження видно в самому матеріалі. Ідеться про одну модель і два цикли. Сигнал для покращення походить із самооцінки. На двох бенчмарках для програмування, Terminal-Bench 2.0 і SWE-bench Verified, на одному з графіків у статті наведено значення 0,96 і 0,94, тобто в перерахунку на токен трохи нижче за вихідне значення. На цих двох тестах графік, отже, не показав виграшу на токен.
Вихідна точка авторів пасує до (загальної) теми «нагляду». Вони пишуть, що одній моделі важко критикувати й покращувати власні складні міркування, коли вона працює в однорідному циклі. Тому вони роблять ставку на кілька екземплярів із різними ролями. Якщо та сама модель і генерує, і оцінює, спільні помилки можуть залишитися непоміченими. Це висновок із самого підходу, а формулювання статті стосуються методу, а не компаній.
Дослідження доводять, що ідея може працювати і що вузьким місцем є перевірка. Вони не доводять, що моделі в повсякденній практиці надійно вдосконалюються без людей. Це узгоджується з фразою Пічаї і не суперечить їй.
Як швидко це може статися: Gladstone і межі прогнозу
Дослідники Anthropic, OpenAI та Google DeepMind очікували, що рекурсивне самовдосконалення почнеться протягом наступних трьох–дванадцяти місяців, можливо, й раніше, за умови, що уряд США не втрутиться і не загальмує цей процес.
Опитані мають власну зацікавленість у динаміці цієї галузі, а автори – організація, що спеціалізується на безпековій політиці.
Автоматизовані дослідження можуть бути технічно можливими, не будучи економічно вигідними. Вузьким місцем є не добрі ідеї, а обчислювальний час для їх перевірки. Це збігається із зауваженням Пічаї про брак обчислювальних потужностей.
Ці висловлювання не виключають одне одного. «Початок» і «кінцевий стан» – різні точки на тому самому шляху. Пічаї каже, що шлях довгий, і водночас описує, що цикли працюють разом із дослідниками. Gladstone очікує, що частина цього незабаром стане автономнішою. Хто читає обидва джерела, бачить картину, в якій рекурсивне самовдосконалення зростає крок за кроком. Спиратися в плануванні лише на кількість місяців ризиковано, бо ці цифри походять із невеликого кола розмов.
Наслідки для МСП: тестувати цикли моделей і зміну моделей
Для компаній ефект проявляється не як вибух інтелекту, а в календарі та техніці. Якщо агенти розвантажують дослідників, нові версії моделей можуть виходити частіше. Але для роботи незалежно від причини важливо одне: моделі змінюються швидше, ніж профільні підрозділи адаптують процеси.
Це має практичні наслідки. Модель може відповідати на той самий промпт інакше, ніж її попередниця. Тон, формат, типи помилок і вартість одного завдання зміщуються. Провайдери припиняють підтримку старих версій, іноді з коротким терміном. А хто покладається на псевдонім «latest», отримує зміни у продуктивне середовище без запиту.
Звідси випливає простий порядок дій для зміни моделі. По-перше, тестовий корпус із реальних завдань, наприклад 50–200 анонімізованих випадків із відомою правильною відповіддю (частково їх можна навіть згенерувати за допомогою ШІ!). По-друге, порівняльний прогін нової моделі проти поточної версії з незмінними промптами. По-третє, затвердження визначеною особою, яка бачила якість, вартість і картину помилок. По-четверте, шлях відкату (rollback), тобто зафіксована версія моделі та збережена конфігурація, щоб повернутися назад за лічені хвилини.
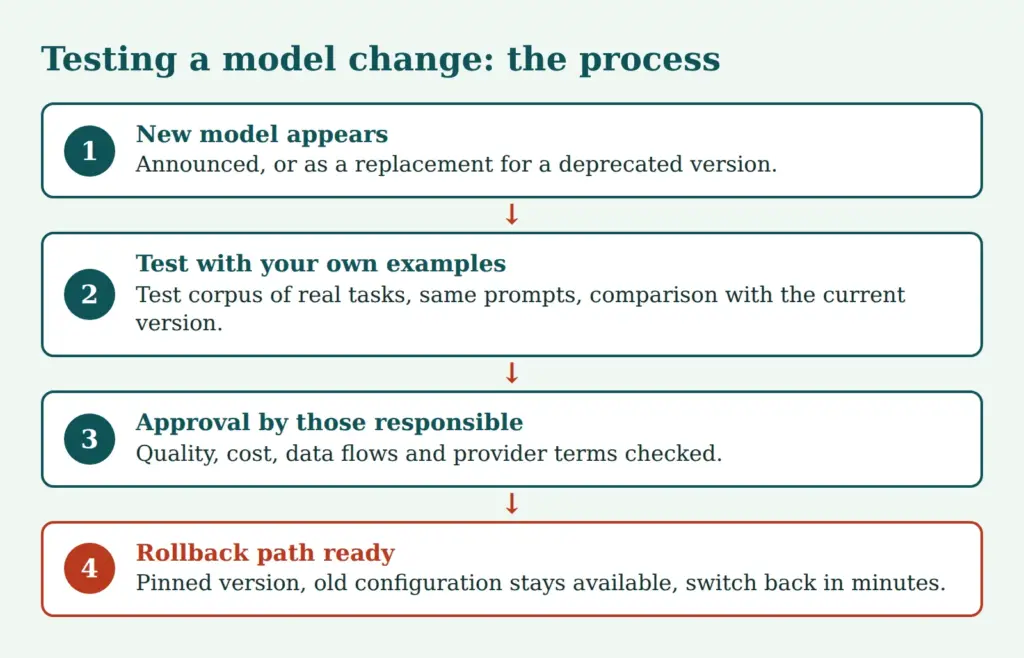
У разі зміни провайдера або нової моделі наявного провайдера додаються захист даних і договір. Слід з’ясувати потоки даних, розташування серверів, обробку даних за дорученням і те, чи використовуються вхідні дані для навчання. Автоматичне оновлення до найновішої моделі не слід дозволяти у продуктивному середовищі. Локальні моделі зміщують питання: вони усувають залежність від провайдера, але потребують власного обслуговування, див. огляд локального ШІ.
Малим компаніям не потрібно для цього створювати власний відділ тестування. Для початку достатньо таблиці з прикладами, скрипта, який проганяє їх через обидві моделі, і короткої нотатки про затвердження.
Зберігати нагляд і затвердження: що залишається завданням людини
Коли розробники у власній компанії використовують агентів із правами запису, у малому масштабі виникає той самий цикл, що й у лабораторіях: агент змінює код, запускаються тести, агент виправляє. Нагляд можна організувати за тим самим зразком. Агент може пропонувати й тестувати, але зміни у продуктивних системах, конфігураціях і даних затверджує визначена особа.
До цього належать журнали, які дають змогу відстежити, що зробив агент, і права, настільки вузькі, наскільки це необхідно. Видалення, надсилання та оплата – це дії, що заслуговують на додаткове підтвердження. Які ризики несе агент без контролю, описує стаття Небезпека ШІ-агентів.
Важливе й питання, хто перевіряє. Якщо та сама модель і генерує, і оцінює, ті самі сліпі зони залишаються. На практиці це означає: один ШІ може перевіряти інший, але лише додатково. Надійна перехресна перевірка походить із тестів, від іншого провайдера або від людини.
ШІ надійно перевіряє ШІ лише тоді, коли перехресна перевірка незалежна: за допомогою тестів, іншого провайдера або людини.
Відповідальність залишається за компанією, яка використовує агента. Це так незалежно від того, наскільки розробка автоматизована у фоновому режимі. Твердження, що ШІ вдосконалює сам себе, не знімає відповідальності з оператора.
Чек-лист
Чек-лист має допомогти відповісти на питання, що робити зараз, а чого не робити:
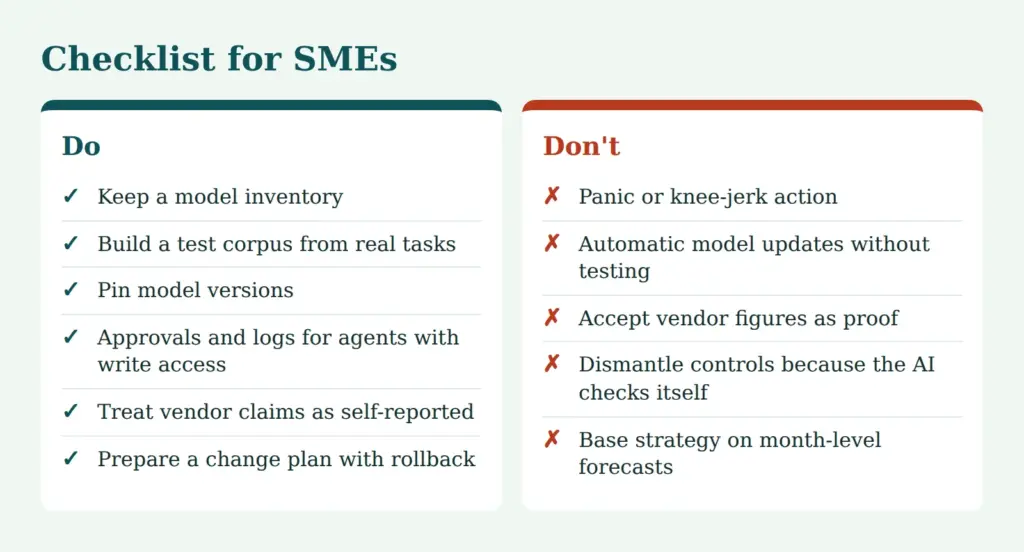
Про окремі пункти:
Реєстр моделей фіксує, які моделі в якій версії де працюють, хто відповідальний і які дані передаються. Тестовий корпус поповнюється з кожною помилкою, помітною під час роботи. Версії фіксуються і змінюються лише після тестування. Для агентів із правами запису діють затвердження та журнали. Заяви виробників, чи то про бенчмарки, чи про частку ШІ в коді, розглядаються як самозвіти, а не як доказ.
Не варто панікувати й діяти поспіхом, бо підтверджена ситуація – це частковий цикл за участі людей. Так само не слід скорочувати контроль лише тому, що ШІ перевіряє сам себе. А стратегії, що спираються на кількість місяців із прогнозів, стоять на хиткому ґрунті. Хто хоче додатково перевірити технічний бік, наприклад права та поверхню атаки систем, знайде відправну точку в перевірках безпеки на wwwschutz.de.
Висновок
Підсумовуючи, висловлювання та поточний стан, який може змінюватися щодня, можна впорядкувати так.
Пічаї підтверджує, що існують цикли зворотного зв’язку з дослідниками і що кінцевий стан без людей ще далеко. Це не привід заспокоюватися. Можливе прочитання таке: шлях уже триває, і за кілька років можливий великий прогрес.
Для МСП важать коротші цикли моделей, тести перед кожною зміною, зафіксовані версії та затвердження для агентів. Чи стане цикл помітно автономнішим через три місяці чи через три роки, сьогодні ніхто достовірно не знає. Хто опанував тести, затвердження та відкат, готовий до обох сценаріїв.
 My name is Klaus Meffert. I have a doctorate in computer science and have been working professionally and practically with information technology for over 30 years. I also work as an expert in IT & data protection. I achieve my results by looking at technology and law. This seems absolutely essential to me when it comes to digital data protection. My company, IT Logic GmbH, also offers consulting and development of optimized and secure AI solutions.